 by
Bayangkan Anda menyimpan akta rumah. Fotokopinya Anda taruh di laci yang sama, lalu suatu malam rumah kebakaran. Akta asli dan fotokopinya hangus bersamaan. Karena itu, orang yang berhati-hati menitipkan salinan ke rumah saudara di kota lain, lalu sesekali mengecek apakah salinan itu masih ada dan masih terbaca. Prinsip yang sama berlaku untuk backup server otomatis: salinan lokal saja tidak cukup, salinan di tempat lain wajib ada, dan harus ada “penjaga” yang memastikan salinan terbaru benar-benar lahir.
Pada tutorial ini kita membangun sistem backup yang sama dengan yang kami jalankan untuk server billing ISP kami. Isinya tiga skrip Bash: backup database dan file konfigurasi tiap jam, salinan off-site yang server lain tarik sendiri, serta watchdog yang memberi alert jika backup basi atau rusak. Selain itu, kita juga menguji restore, karena backup yang belum pernah Anda pulihkan belum terbukti. Kami sudah menguji semua kode di server uji, lalu mengganti IP, nama host, dan password dengan nilai contoh.
Kenapa Backup Server Otomatis Butuh Tiga Bagian?
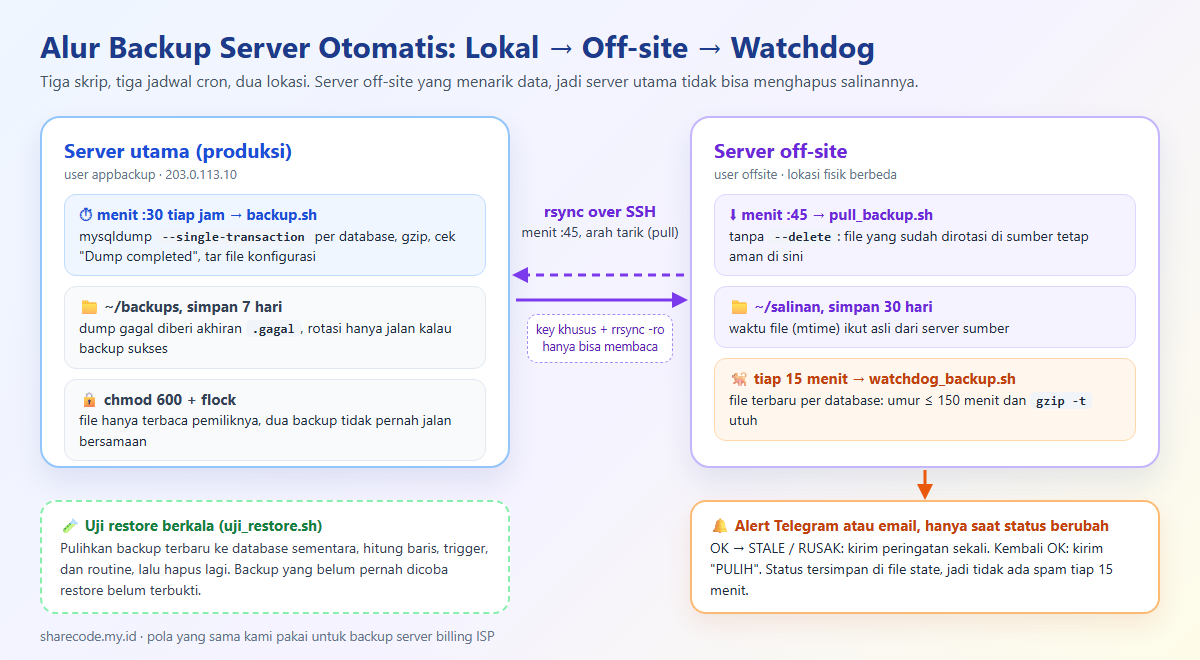
Sampai Juni 2026, server billing kami belum punya backup yang layak. Memang ada sinkronisasi harian ke server dev, tetapi kami sudah menyanitasi data itu: token WhatsApp, key payment gateway, dan password router sengaja kami kosongkan. Artinya, sinkronisasi itu aman untuk sandbox, namun tidak berguna untuk restore. Sejak saat itu kami memecah tugas backup menjadi tiga bagian seperti tabel berikut.
| Bagian | Lokasi | Jadwal | Tugas | Simpan |
|---|---|---|---|---|
| backup.sh | Server utama | Tiap jam, menit :30 | Dump database, arsip config, validasi, rotasi | 7 hari |
| pull_backup.sh | Server off-site | Tiap jam, menit :45 | Tarik file baru lewat rsync over SSH | 30 hari |
| watchdog_backup.sh | Server off-site | Tiap 15 menit | Cek umur dan keutuhan file terbaru, kirim alert | – |
| uji_restore.sh | Server off-site | Berkala | Pulihkan ke database sementara lalu periksa isinya | – |
Sebagai gambaran ukuran, setiap jam server billing kami menghasilkan dump database utama sekitar 2,2 MB, dump RADIUS 7,4 MB, dan arsip config 13 KB (semua tergzip). Dalam 7 hari, folder lokal berisi 578 file sebesar 1,6 GB. Sementara itu, server off-site menyimpan 2.232 file sebesar 4,9 GB untuk 30 hari.
Persiapan: User MySQL Khusus Backup
Pertama, jangan memakai user root atau user aplikasi untuk backup. Buat user khusus yang hanya boleh membaca. Contoh berikut memakai database tokodemo di MariaDB 11.8.
CREATE USER 'appbackup'@'localhost' IDENTIFIED BY 'GantiPasswordKuat#2026';
GRANT SELECT, SHOW VIEW, TRIGGER, LOCK TABLES, EVENT ON tokodemo.* TO 'appbackup'@'localhost';
GRANT SHOW CREATE ROUTINE ON tokodemo.* TO 'appbackup'@'localhost';
Baris kedua cukup untuk tabel, view, trigger, dan event. Kemudian baris ketiga memberi akses membaca stored procedure di MariaDB 11.3 ke atas. Di MySQL 8, hak serupa bernama SHOW_ROUTINE dan berlaku global. Selanjutnya, buat user Linux appbackup dengan sudo useradd -m -s /bin/bash appbackup agar file backup punya pemilik sendiri.
Simpan Password di File Opsi, Bukan di Skrip
Skrip produksi lama kami menulis password langsung di perintah mysqldump -p.... Akibatnya, log selalu penuh peringatan Using a password on the command line interface can be insecure, dan password ikut terlihat di daftar proses. Cara yang lebih rapi adalah file opsi milik user backup.
sudo -u appbackup tee /home/appbackup/.backup.cnf >/dev/null <<'EOF'
[client]
user=appbackup
password="GantiPasswordKuat#2026"
EOF
sudo chmod 600 /home/appbackup/.backup.cnf
Perhatikan tanda kutip pada password. Di server uji, kami awalnya menulis password tanpa kutip, dan dump langsung gagal dengan Access denied. Ternyata MySQL membaca tanda # sebagai awal komentar, sehingga password terpotong. Untungnya, validasi di skrip berikut langsung menangkap kegagalan itu.
Langkah 1: Skrip backup.sh di Server Utama
Skrip ini cukup panjang, jadi kita bahas per bagian. Simpan ketiga bagian berurutan dalam satu file /home/appbackup/backup.sh.
Bagian 1: Variabel dan Kunci Anti-Tumpang-Tindih
#!/bin/bash
# backup.sh - backup database + file konfigurasi, dijalankan cron tiap jam
set -uo pipefail

DIR=/home/appbackup/backups
LOG=/home/appbackup/backup.log
CNF=/home/appbackup/.backup.cnf
DBS="tokodemo"
FILES="/srv/tokodemo/config"
KEEP_DAYS=7
MIN_SIZE=1000
TS=$(date +%Y%m%d_%H%M%S)

mkdir -p "$DIR" && chmod 700 "$DIR"
exec 9>/tmp/appbackup.lock
flock -n 9 || { echo "[$(date)] skip: backup lain masih jalan" >>"$LOG"; exit 0; }
Isi DBS dengan beberapa nama database yang terpisah spasi, dan FILES dengan folder config yang tidak masuk Git. Kemudian flock -n memastikan hanya satu backup yang berjalan. Misalnya, jika dump jam 10:30 masih berjalan saat cron 11:30 mulai, proses kedua langsung keluar dan mencatat “skip”.
Bagian 2: Dump Setiap Database dan Validasi
status=OK
for db in $DBS; do
  out="$DIR/${db}_$TS.sql.gz"
  mysqldump --defaults-extra-file="$CNF" --single-transaction --quick \
    --routines --triggers --no-tablespaces "$db" 2>>"$LOG" | gzip > "$out"
  rc=${PIPESTATUS[0]}
  sz=$(stat -c%s "$out")
  if [ "$rc" -ne 0 ] || [ "$sz" -lt "$MIN_SIZE" ] ||
     ! zcat "$out" | tail -n 1 | grep -q "Dump completed"; then
    echo "[$(date)] GAGAL dump $db (rc=$rc size=${sz}B)" >>"$LOG"
    mv "$out" "$out.gagal"
    status=GAGAL
  fi
done
Opsi --single-transaction membuat snapshot InnoDB yang konsisten tanpa mengunci tabel, sehingga aplikasi tetap bisa menulis selama dump berjalan. Selain itu, --quick mengalirkan baris satu per satu agar RAM tetap hemat. Validasi memakai tiga pemeriksaan: exit code mysqldump (lewat PIPESTATUS, karena exit code pipa biasanya milik gzip), ukuran minimal, dan baris penutup -- Dump completed. Jika salah satu gagal, file berganti nama menjadi .gagal agar tidak terlihat seperti backup sehat.
Bagian 3: Arsip Config, Izin File, dan Rotasi
tar czf "$DIR/files_$TS.tar.gz" $FILES 2>>"$LOG" || status=GAGAL
chmod 600 "$DIR"/*_"$TS"* 2>/dev/null

if [ "$status" = OK ]; then
  find "$DIR" -maxdepth 1 -type f \( -name '*.gz' -o -name '*.gagal' \) \
    -mtime +"$KEEP_DAYS" -delete
fi

total=$(du -sh "$DIR" | cut -f1)
echo "[$(date)] backup $status ts=$TS total=$total" >>"$LOG"
File config berisi password database dan API key, jadi chmod 600 wajib. Kemudian rotasi hanya berjalan kalau backup kali ini sukses. Dengan demikian, saat database bermasalah berhari-hari, skrip tidak terus menghapus backup lama yang justru menjadi satu-satunya salinan sehat.
Jalankan dan Pasang Cron
sudo chmod 700 /home/appbackup/backup.sh
sudo -u appbackup /home/appbackup/backup.sh
sudo -u appbackup tail -n 2 /home/appbackup/backup.log
# [Mon Nov  2 17:25:02 UTC 2026] backup OK ts=20261102_172502 total=36K

# cron user appbackup: tiap jam menit 30
echo "30 * * * * /home/appbackup/backup.sh" | sudo crontab -u appbackup -
Kami memilih menit 30, bukan menit 0, karena banyak cron lain (generate invoice, isolir pelanggan) berjalan di awal jam. Setelah itu, cek journalctl -u cron pada menit 30 berikutnya untuk memastikan cron benar-benar memanggil skrip.
Contoh Kasus: Satu Database Gagal, Log Tetap Bilang OK
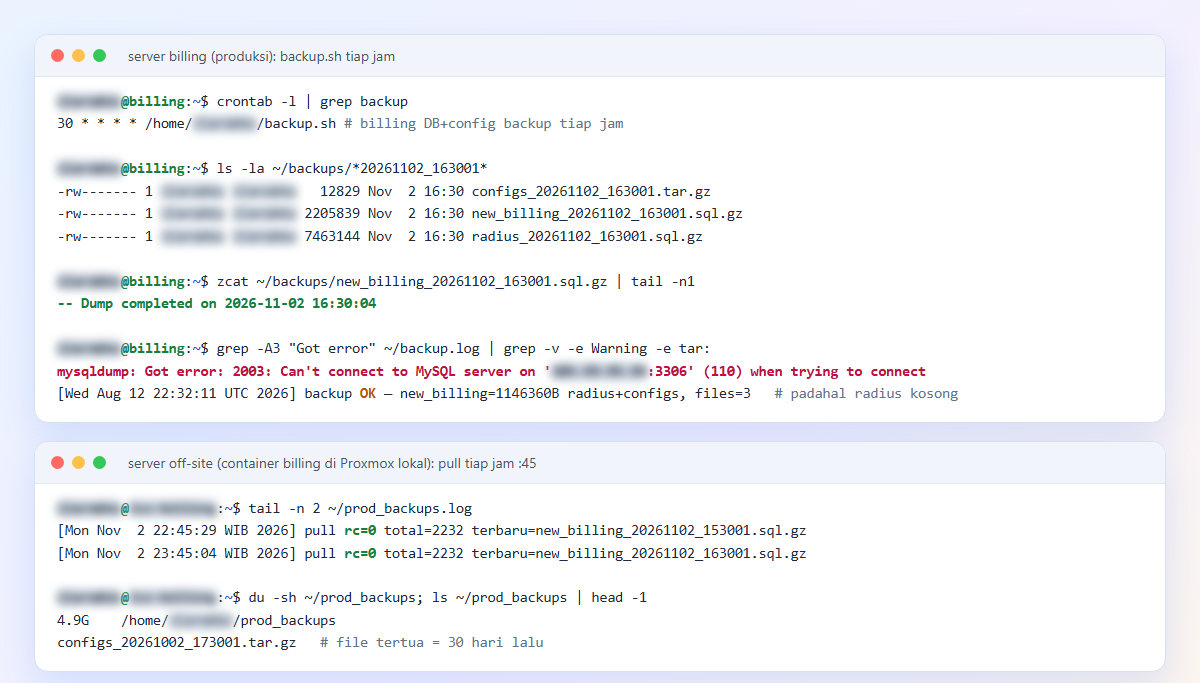
Pada 12 Agustus 2026 pukul 22:30 UTC, server database RADIUS kami tidak bisa terhubung (error 2003, timeout 110). Akibatnya, dump RADIUS jam itu kosong. Namun, log tetap menulis “backup OK”, karena skrip produksi kami saat itu hanya memvalidasi database billing utama. Kami baru menyadarinya saat membaca ulang log untuk artikel ini. Oleh karena itu, versi di atas memvalidasi setiap database di dalam loop, dan watchdog di langkah 3 juga memeriksa file terbaru per database.
Langkah 2: Salinan Off-site dengan rsync Pull
Backup yang hanya tinggal di server utama akan ikut hilang saat disk rusak, VPS terhapus, atau server kena ransomware. Karena itu, server kedua di lokasi fisik berbeda harus menyimpan salinan. Ada dua arah: server utama mengirim (push) atau server off-site menarik (pull). Kami memilih pull, karena server utama tidak perlu menyimpan kredensial apa pun ke server off-site. Jadi, penyerang yang menguasai server utama tetap tidak bisa menghapus salinan off-site.
Key SSH yang Hanya Bisa Membaca
Di server off-site, buat user offsite dan key SSH khusus tanpa passphrase, lalu daftarkan public key-nya di server utama dengan pembatas rrsync.
# di server off-site, sebagai user offsite
ssh-keygen -t ed25519 -N "" -C offsite-pull -f ~/.ssh/id_pull
cat ~/.ssh/id_pull.pub

# di server utama: satu baris di /home/appbackup/.ssh/authorized_keys
command="/usr/bin/rrsync -ro /home/appbackup/backups/",restrict ssh-ed25519 AAAAC3...contoh offsite-pull
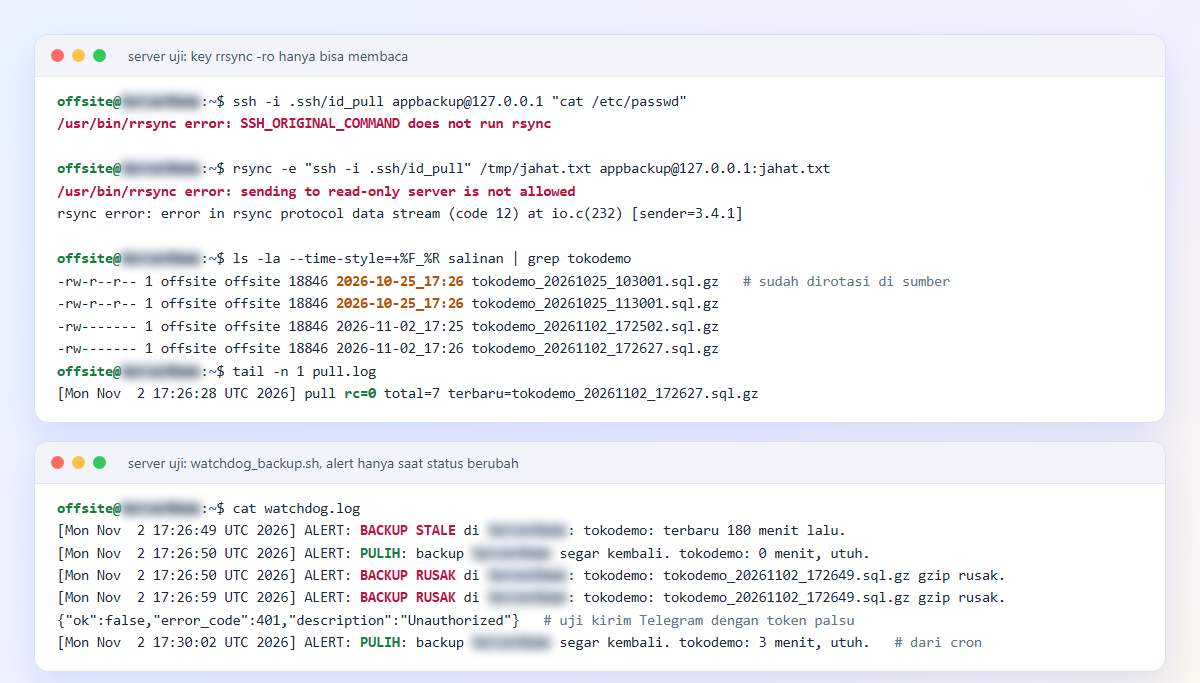
Skrip rrsync ikut terpasang bersama paket rsync di Ubuntu. Opsi -ro membatasi key ini hanya untuk membaca folder backups, sedangkan restrict mematikan shell, port forwarding, dan PTY. Kami mengujinya dengan dua percobaan: menjalankan cat /etc/passwd lewat key ini, lalu mengirim file ke server utama. Hasilnya, rrsync menolak keduanya.
Skrip pull_backup.sh
#!/bin/bash
# pull_backup.sh - jalan di server OFF-SITE, menarik backup dari server utama
set -uo pipefail

SRC=appbackup@203.0.113.10:
DST=/home/offsite/salinan
LOG=/home/offsite/pull.log
KEY=/home/offsite/.ssh/id_pull
KEEP_DAYS=30

mkdir -p "$DST" && chmod 700 "$DST"
exec 9>/tmp/offsite_pull.lock
flock -n 9 || { echo "[$(date)] skip: pull lain masih jalan" >>"$LOG"; exit 0; }

rsync -az --timeout=60 --exclude='*.gagal' \
  -e "ssh -i $KEY -o BatchMode=yes -o StrictHostKeyChecking=accept-new" \
  "$SRC" "$DST/" >>"$LOG" 2>&1
rc=$?

find "$DST" -maxdepth 1 -type f -name '*.gz' -mtime +"$KEEP_DAYS" -delete

cnt=$(find "$DST" -maxdepth 1 -name '*.gz' | wc -l)
newest=$(ls -t "$DST"/*.sql.gz 2>/dev/null | head -1)
echo "[$(date)] pull rc=$rc total=$cnt terbaru=$(basename "${newest:-none}")" >>"$LOG"
Path sumber cukup appbackup@203.0.113.10:, karena rrsync sudah mengarahkan key ke folder backups. Kemudian -a mempertahankan waktu file asli, dan detail ini penting untuk watchdog. Sengaja tidak ada --delete, sehingga file yang sudah terhapus rotasi 7 hari di sumber tetap tersimpan 30 hari di sini. Pasang cron 45 * * * * untuk user offsite.
Contoh Kasus: Memindahkan Server Off-site
Awalnya, server off-site kami adalah VPS dev. Pada November 2026 kami mematikan VPS dev dan pindah ke Proxmox lokal. Berkat model pull, server billing sama sekali tidak perlu berubah. Kami cukup menyalin 4,8 GB backup lama ke container baru, memasang skrip dan cron yang sama, lalu memastikan firewall server billing tetap mengizinkan IP keluar container. Hasilnya, tarikan pertama di lokasi baru langsung selesai dengan rc=0.
Langkah 3: Watchdog Umur Backup
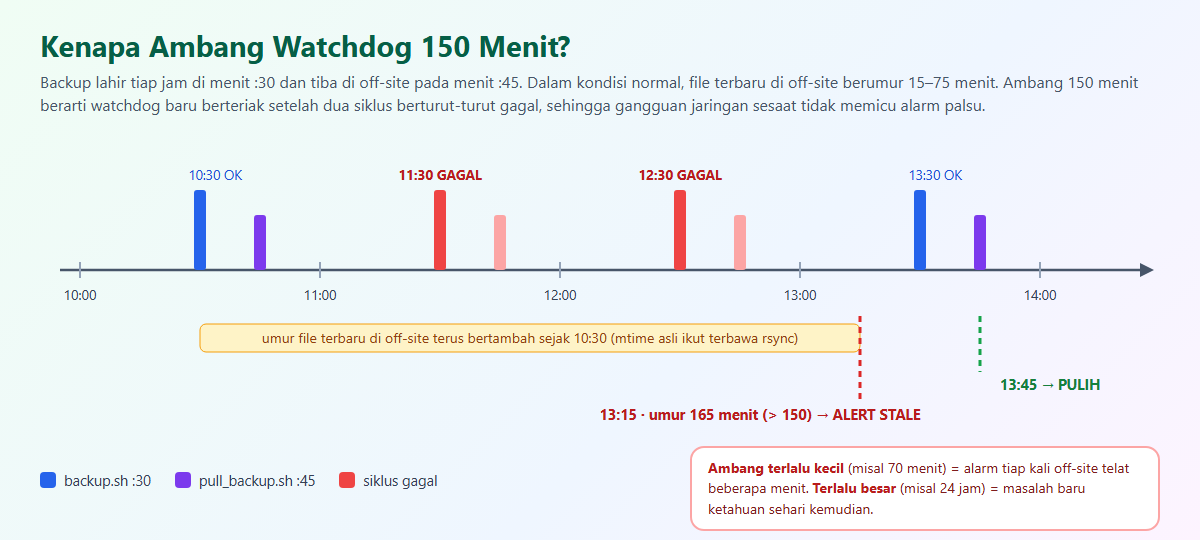
Backup bisa berhenti diam-diam: cron mati, disk penuh, password berubah, atau server off-site tidak bisa menghubungi sumber. Karena itu, watchdog mengukur hal yang paling jujur, yaitu umur file terbaru di server off-site. Satu pemeriksaan ini sekaligus menangkap kegagalan backup dan kegagalan pull.
Bagian 1: Konfigurasi dan Fungsi Alert
#!/bin/bash
# watchdog_backup.sh - cek umur & keutuhan backup terbaru, alert hanya saat status berubah
set -uo pipefail

DST=/home/offsite/salinan
DBS="tokodemo"
MAX_AGE_MIN=150
STATE=/home/offsite/.wd_backup
LOG=/home/offsite/watchdog.log
TG_TOKEN=""
TG_CHAT=""

kirim_alert() {
  echo "[$(date)] ALERT: $1" >>"$LOG"
  [ -z "$TG_TOKEN" ] && return
  curl -s --max-time 20 "https://api.telegram.org/bot$TG_TOKEN/sendMessage" \
    -d chat_id="$TG_CHAT" --data-urlencode text="$1" >>"$LOG" 2>&1
  echo >>"$LOG"
}
Isi TG_TOKEN dan TG_CHAT dengan token bot dan chat ID Telegram Anda. Jika keduanya kosong, alert hanya masuk ke log, cocok untuk uji coba. Kami menguji format permintaannya dengan token palsu, dan API Telegram membalas 401 Unauthorized. Artinya, permintaan sudah sampai dan hanya token yang salah.
Bagian 2: Cek Umur, Keutuhan, dan Perubahan Status
cur=OK; info=""
for db in $DBS; do
  newest=$(ls -t "$DST"/${db}_*.sql.gz 2>/dev/null | head -1)
  if [ -z "$newest" ]; then
    cur=STALE; info="$info $db: tidak ada file."; continue
  fi
  age=$(( ( $(date +%s) - $(stat -c %Y "$newest") ) / 60 ))
  if [ "$age" -gt "$MAX_AGE_MIN" ]; then
    cur=STALE; info="$info $db: terbaru ${age} menit lalu."
  elif ! gzip -t "$newest" 2>/dev/null; then
    cur=RUSAK; info="$info $db: $(basename "$newest") gzip rusak."
  else
    info="$info $db: ${age} menit, utuh."
  fi
done

prev=$(cat "$STATE" 2>/dev/null || echo OK)
if [ "$cur" != "$prev" ]; then
  if [ "$cur" = OK ]; then
    kirim_alert "PULIH: backup $(hostname) segar kembali.$info"
  else
    kirim_alert "BACKUP $cur di $(hostname):$info"
  fi
  echo "$cur" > "$STATE"
fi
Watchdog membandingkan status sekarang dengan status sebelumnya di file state. Hasilnya, alert hanya terkirim saat status berubah: sekali saat bermasalah dan sekali saat pulih. Pola ini sama dengan watchdog billing kami yang memantau uptime, cron, dan disk, jadi ponsel tidak berbunyi tiap 15 menit. Pasang cron */15 * * * * untuk user offsite.
Uji Watchdog dengan Memundurkan Waktu File
# pura-pura backup terakhir lahir 3 jam lalu
for f in ~/salinan/tokodemo_20261102_*.sql.gz; do touch -d "3 hours ago" "$f"; done
./watchdog_backup.sh; ./watchdog_backup.sh; cat ~/watchdog.log
# [Mon Nov  2 17:26:49 UTC 2026] ALERT: BACKUP STALE di ServerDemo: tokodemo: terbaru 180 menit lalu.
Walaupun watchdog berjalan dua kali, alert hanya muncul sekali. Setelah itu, kami menjalankan backup dan pull lagi, dan watchdog menulis “PULIH”. Kami juga memotong satu file dump dengan head -c 5000, dan watchdog langsung melaporkan RUSAK. Menariknya, pull berikutnya otomatis memperbaiki file itu, karena rsync melihat ukurannya berbeda dari sumber.
Contoh Kasus: Watchdog Ikut Mati dan Port SMTP Terblokir
Watchdog billing kami dulu berjalan di VPS dev dan mengirim alert lewat email Brevo. Masalah pertama, VPS itu memblokir port SMTP keluar 25, 465, dan 587, sehingga kami harus memakai port alternatif 2525. Masalah kedua lebih halus: saat VPS dev kami matikan, watchdog ikut mati tanpa suara. Oleh karena itu, kami memindahkan watchdog ke VPS jembatan yang berdiri sendiri. Pelajarannya, letakkan watchdog di server yang berbeda dari yang ia awasi, dan pastikan jalur alert-nya pernah teruji.
Langkah 4: Uji Restore, Bagian yang Paling Sering Terlewat
Skrip berikut memulihkan backup terbaru ke database sementara, menghitung isinya, lalu menghapusnya lagi. Jalankan dari server off-site dengan user MySQL yang hanya punya hak penuh atas database uji, misalnya GRANT ALL ON `tokodemo\_uji\_restore`.* TO 'offsite'@'localhost'.
#!/bin/bash
# uji_restore.sh - pulihkan backup terbaru ke database sementara lalu periksa isinya
set -euo pipefail

DST=/home/offsite/salinan
DB=tokodemo
UJI=${DB}_uji_restore
SQL="mysql --defaults-extra-file=/home/offsite/.restore.cnf"
trap '$SQL -e "DROP DATABASE IF EXISTS $UJI"' EXIT

file=$(ls -t "$DST"/${DB}_*.sql.gz | head -1)
echo "File    : $(basename "$file")"
gzip -t "$file" && echo "gzip    : utuh"

$SQL -e "DROP DATABASE IF EXISTS $UJI; CREATE DATABASE $UJI"
zcat "$file" | sed -E 's/DEFINER=`[^`]+`@`[^`]+`//g' | $SQL "$UJI"

for t in $($SQL -N -e "SHOW TABLES" "$UJI"); do
  printf "%-12s %s baris\n" "$t" "$($SQL -N -e "SELECT COUNT(*) FROM \`$t\`" "$UJI")"
done
echo "Trigger : $($SQL -N -e "SHOW TRIGGERS" "$UJI" | wc -l)"
echo "Routine : $($SQL -N -e "SHOW PROCEDURE STATUS WHERE Db='$UJI'" | wc -l)"
echo "Restore : BERHASIL (database uji dihapus otomatis)"
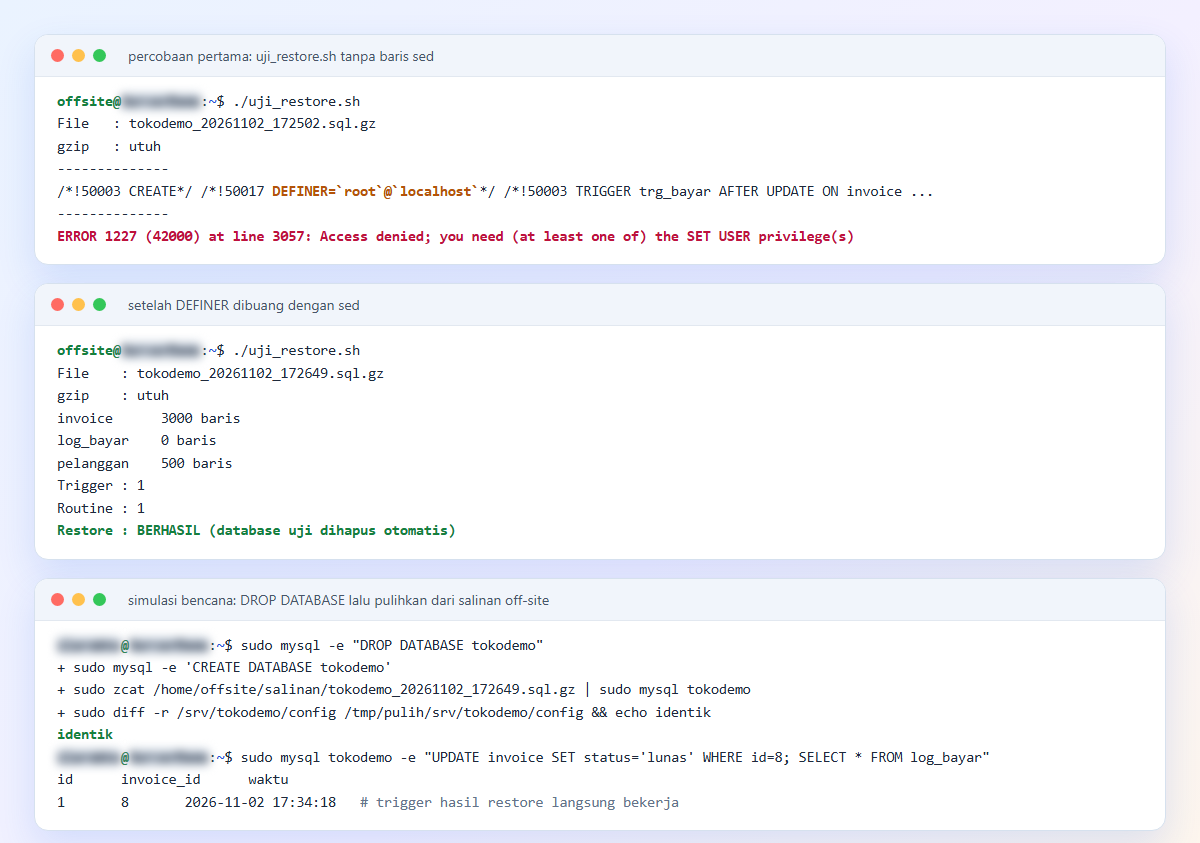
Perintah trap ... EXIT menghapus database uji apa pun hasilnya, termasuk saat restore gagal di tengah jalan. Kemudian baris sed membuang klausa DEFINER dari trigger dan procedure, dan alasannya ada di contoh kasus berikut.
Contoh Kasus: Restore Pertama Langsung Gagal
Versi pertama skrip ini belum punya baris sed. Hasilnya, restore berhenti di baris 3057 dengan ERROR 1227: Access denied; you need (at least one of) the SET USER privilege(s). Penyebabnya, mysqldump menulis trigger lengkap dengan DEFINER=`root`@`localhost`, sementara user restore bukan root. Seandainya kami baru mengetahuinya saat bencana sungguhan, proses pemulihan bisa tertunda sementara semua orang panik. Setelah kami menambahkan sed, restore berhasil: 3.000 invoice, 500 pelanggan, 1 trigger, dan 1 procedure, persis sama dengan sumbernya.
Restore Sungguhan Saat Bencana
# 1. database: buat ulang lalu isi dari salinan off-site
sudo mysql -e "CREATE DATABASE tokodemo"
sudo zcat /home/offsite/salinan/tokodemo_20261102_172649.sql.gz | sudo mysql tokodemo

# 2. config: ekstrak ke folder sementara, bandingkan dulu, baru salin
mkdir -p /tmp/pulih && sudo tar xzf /home/offsite/salinan/files_20261102_172649.tar.gz -C /tmp/pulih
sudo diff -r /srv/tokodemo/config /tmp/pulih/srv/tokodemo/config && echo "identik"
Di server uji, kami sengaja menjalankan DROP DATABASE tokodemo, lalu memulihkannya dengan perintah di atas. Setelah itu, trigger pembayaran dan procedure total_lunas langsung bekerja lagi. Untuk config, jangan langsung mengekstrak ke /. Bandingkan dulu dengan diff, karena arsip lama bisa menimpa password yang baru saja Anda ganti.
Kesalahan Umum
- Hanya menyimpan backup di server yang sama. Disk rusak atau VPS terhapus akan melenyapkan data dan backup sekaligus.
- Menganggap file ada berarti backup sehat. Dump gagal tetap menghasilkan file gzip 20 byte. Selalu cek exit code, ukuran, dan baris “Dump completed”.
- Memakai
--skip-commentsatau--compact. Kedua opsi ini membuang baris “Dump completed”, sehingga validasi selalu gagal. - Password berisi
#tanpa tanda kutip di file.cnf. MySQL memotong password di tanda itu. - Memakai
rsync --deletepada salinan off-site. Rotasi atau penghapusan di sumber ikut menghapus salinan Anda. - Watchdog di server yang sama dengan yang ia awasi. Saat server itu mati, alert juga mati.
- Tidak pernah menguji restore. Masalah DEFINER, charset, atau hak akses baru ketahuan saat Anda paling butuh.
Kesimpulan
Backup server otomatis yang bisa Anda andalkan terdiri dari tiga bagian yang saling menjaga. Pertama, backup.sh membuat dump konsisten tiap jam dengan --single-transaction dan menolak hasil yang cacat. Kedua, server off-site menarik salinan lewat key read-only, sehingga server utama tidak bisa menghapusnya. Ketiga, watchdog mengukur umur file terbaru dan hanya berbunyi saat status berubah.
Namun, sistem ini baru terbukti setelah Anda berhasil memulihkannya. Di kasus kami, uji restore pertama justru gagal karena DEFINER, dan log produksi pernah menulis “OK” padahal satu database kosong. Karena itu, jadwalkan uji restore berkala, baca log sesekali, dan pindahkan watchdog ke server yang berbeda. Dengan demikian, saat bencana benar-benar datang, Anda tinggal menjalankan perintah yang sudah teruji.
Baca Juga
- Keamanan Server Linux: Tutorial Hardening SSH, Firewall UFW, CrowdSec, dan Alarm Telegram
- Cara Membuat Dashboard Monitoring Server (NOC) dengan Uptime Kuma dan Beszel
- Cara Akses Proxmox dari Internet Tanpa IP Publik (WireGuard + VPS)
Referensi: MariaDB: mariadb-dump, MySQL 8.0: mysqldump, rsync(1) manual, flock(1), Telegram Bot API: sendMessage.